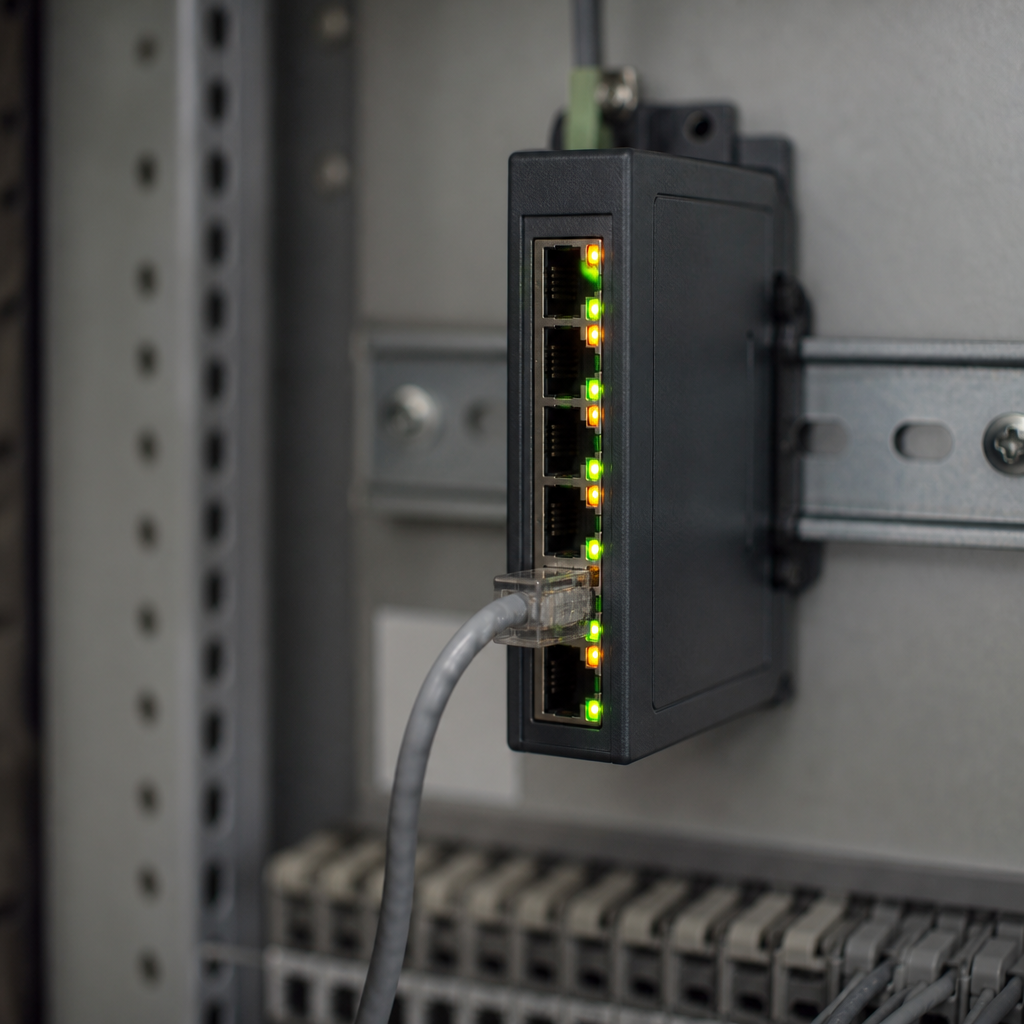
Цеховой шкаф АСУ ТП поставили с «свитчом из компьютерного магазина» - пять портов, без управления, цена в три раза ниже промышленного. На пуске всё работает: Modbus TCP отвечает, Profinet зелёный, тренды бегут. Через месяц, в понедельник утром, оператор жалуется: «ПЛК то отвечает, то молчит тридцать секунд». Инженер приезжает, пингует - всё ок. Перезагрузил свитч - сутки тишины. На следующей неделе снова. В логах SCADA - рост таймаутов Modbus, в диагностике Profinet - Not Available на части устройств. А на свитче нет ни счётчиков ошибок, ни журнала, ни storm control.
Здесь не курс по прокладке Ethernet и не сравнение брендов коммутаторов. Разбираем, почему офисный unmanaged switch в OT-сегменте даёт broadcast storm, петли и потери циклов опроса, как это выглядит на Modbus TCP и Profinet, и когда без промышленного Ethernet не обойтись. Статья не про firewall и маршрутизацию между цехом и серверной - это отдельный контур.
Короткий ответ
Офисный свитч в шкафу АСУ ТП часто «работает», пока не появляется петля, лавина broadcast или перегрузка буфера. Unmanaged устройство не ограничивает шторм, не отсекает порт при петле, не даёт диагностики. Симптомы на объекте: рваный опрос Modbus TCP, рост таймаутов и exception, Profinet Not Available, «залипшие» теги GOOD без обновления, потери циклов ПЛК при росте сетевой нагрузки.
Проверка: исключить второй путь между портами (двойной патч, незакрытый uplink), посмотреть счётчики на managed/industrial свитче, временно отключить подозрительные ветки, сравнить загрузку CPU ПЛК до и после обрыва петли. Для постоянной работы в OT - industrial Ethernet с storm control, loop protection, при необходимости VLAN и IGMP snooping для multicast Profinet. Офисный свитч оставляют только на изолированном тестовом стенде FAT, не в production сегменте.
Почему «пинг есть» не спасает
Ping - один маленький пакет раз в секунду. Цикл Modbus TCP - десятки транзакций в секунду, Profinet - постоянный IO traffic и multicast. Офисный свитч с маленьким буфером и без приоритизации может отбрасывать UDP и TCP при всплеске broadcast. Пинг проходит, а опрос регистров срывается.
На FAT часто тестируют «связь есть» с ноутбука в том же сегменте. Ноутбук не создаёт ту же нагрузку, что SCADA плюс три HMI плюс камера плюс «временно подключили Wi-Fi точку для наладки». Разрыв между стендом и цехом - типичная причина, почему офисный свитч «прошёл приёмку» и сломался в эксплуатации.
Broadcast storm: откуда лавина в шкафу
Broadcast storm - когда широковещательные пакеты (ARP, DHCP, неизвестные MAC, ошибочный multicast) множатся быстрее, чем свитч их отбрасывает. В unmanaged устройстве каждый broadcast уходит на все порты. Петля удваивает трафик каждый цикл. Через секунды сегмент забит.
Источники на реальных объектах: два патч-корда между двумя свитчами «для надёжности», незакрытый порт с кабелем в обе стороны, подключение офисного принтера в тот же свитч, что ПЛК, Wi-Fi точка в режиме bridge, неправильная топология кольца без протокола кольца. Инженер АСУ ТП не всегда виноват - но первым видит «ПЛК не отвечает».
Признаки storm: все LED на свитче мигают синхронно, link up, но Modbus timeout на всех устройствах сегмента, Profinet diagnostics - communication error, CPU ПЛК растёт из-за обработки сетевого стека. Перезагрузка свитча временно обнуляет буферы - и создаёт иллюзию «свитч глючный, надо заменить на другой такой же».
Петля и кольцо: unmanaged не прощает
Промышленные кольца (MRP, RSTP, PRP) предполагают управляемый коммутатор с протоколом. Если в шкаф положили кольцо «как в схеме», но свитч офисный - петля открыта всегда. Офисный свитч без loop protection не отключит порт при петле.
Даже без кольца петлю делает человек: «второй кабель для резерва» между двумя шкафами без L2 redundancy. На FAT кабель убрали, на объекте электрик «доложил» второй путь после переезда щита. Диагностика без managed switch - методом отключения портов по одному, что на работающем цехе неприятно.
IGMP и multicast: Profinet на офисном свитче
Profinet RT использует multicast. Офисный unmanaged свитч рассылает multicast как broadcast на все порты. Каждый участник сегмента получает весь IO traffic всех устройств. При росте числа узлов нагрузка на NIC ПЛК и HMI растёт линейно, а не по факту подписки.
IGMP snooping на industrial switch ограничивает multicast целевым портам. Без него «Profinet Not Available» после добавления второго ПЛК в тот же свитч - частый сценарий: не GSD и не CPU, а перегрузка. После замены CPU с другим MAC иногда «магически» помогает перезагрузка - на самом деле сбросилась ARP и временно упала нагрузка.
VLAN: когда офисный свитч даже не умеет
Сегментация OT/IT через VLAN на unmanaged не настроить. Если в тот же свитч воткнули порт в корпоративную сеть «для удобства SCADA», broadcast из IT (обновления Windows, discovery) попадает на ПЛК. VLAN на industrial switch изолирует OT; без него единственная защита - физический отдельный свитч и firewall, как в материале про Modbus TCP цеха, ping и firewall.
Симптомы на Modbus TCP
Modbus TCP чувствителен к latency и jitter. При storm транзакции не доходят в timeout клиента. В логе SCADA - рост timeout, иногда exception Busy от устройства, которое реально занято отбрасыванием пакетов. Unit id и регистры верные - ошибка сетевого слоя.
Цикл опроса «рвётся»: часть тегов обновилась, часть Bad quality, паттерн хаотичный, не как при обрыве одного кабеля. Wireshark на mirror port показывает flood ARP или duplicate packets. Без managed switch mirror часто нет - остаётся снять трафик с одного узла и сравнить с нормальным сегментом.
Потери циклов ПЛК: если ПЛК сам Modbus slave и сеть забита, CPU тратит время на стек, цикл задачи удлиняется. Сверху видят «ПЛК тормозит», внизу - сетевой шторм. Подробнее про таймауты на объекте - в статье Modbus RTU vs TCP.
Симптомы на Profinet
Not Available на части устройств при живом link LED. Диагностика - timeout на IO connection, DCP видит устройство, но cyclic data не идёт. После «потрясти» свитч или переподключить кабель - минутная норма, затем деградация.
Замена CPU без смены свитча иногда совпадает с сценарием Not Available после замены CPU - но если корень в storm, GSD не поможет. Проверяют сегмент до правки проекта.
Таблица: симптом сети, офисный vs industrial, проверка
| Симптом на объекте | Офисный unmanaged | Industrial / managed | Что проверить первым |
|---|---|---|---|
| Все устройства сегмента рваный опрос | буфер переполнен, broadcast flood | storm control срабатывает, порт в errdisabled | петля, двойной uplink, ARP flood |
| Ping стабильный, Modbus timeout | малые пакеты проходят, TCP/UDP теряются | QoS / приоритет RT traffic | загрузка порта, счётчики discard |
| Profinet NA после добавления узла | multicast на все порты | IGMP snooping, фильтрация | число подписок, GSD, не только CPU |
| Помогает reboot свитча 1-2 сутки | буферы обнулились, петля снова растёт | loop protection отсекает порт | топология, второй кабель «резерв» |
| Рост CPU ПЛК без изменения программы | NIC обрабатывает flood | нормальная загрузка стека | трафик на mirror, отключение портов |
| Проблема в «час пик» смены | broadcast от IT/камер в общем свитче | VLAN OT изолирован | куда физически подключены посторонние |
Storm control и loop protection: что должно быть на industrial
Storm control ограничивает процент broadcast/multicast на порт. При превышении порт throttle или shutdown. Loop protection (RLDP, простой loop detect) отключает порт, на котором видит собственные BPDU или echo петли. Это не замена RSTP, но на звезде в шкафу часто достаточно.
Для Profinet - IGMP snooping и иногда static multicast filter. Для диагностики - счётчики ошибок на порту, syslog, SNMP. На FAT стоит записать в протокол: модель свитча, включён ли storm control, есть ли loop guard. «Свитч любой» в акте - подарок для споров на пуске.
Когда офисный свитч ещё терпим
Изолированный стенд FAT в серверной: один ПЛК, один ноутбук, нет uplink в корпоративную сеть. Временная наладка с обязательной заменой перед сдачей. Документ «временно, до поставки industrial» с датой.
Никогда: production цех, общий свитч с камерами и АРМ, кольцо без протокола, сегмент с Profinet IO больше трёх-четырёх устройств на unmanaged. Цена одного часа простоя цеха обычно выше разницы в цене коммутатора.
Диагностика на объекте без лаборатории
Соберите список всего, что подключено к подозрительному свитчу: ПЛК, HMI, SCADA link, камеры, «ещё один свитч на столе мастера». Отключайте не критичные порты по одному в согласованное окно - если storm падает, виновник на этом порту или за ним.
Проверьте дублирующие кабели между шкафами. Сравните время цикла ПЛК и счётчики ошибок Modbus до и после. Если есть второй managed свитч выше - посмотрите counters на uplink в шкаф АСУ ТП.
Тест 30-секундного обрыва из протокола FAT на этом сегменте показывает, как SCADA переживает потерю линка. Storm - другой тест: нагрузка растёт при живом link. Не путайте сценарии в журнале разбора.
Проектирование: что записать в спецификацию шкафа
В спецификации шкафа указать: industrial Ethernet switch, количество портов с запасом 30%, storm control enabled, loop protection, IGMP snooping для Profinet сегмента, отдельный OT VLAN, uplink только в OT firewall или core OT switch. Запрет на sharing с офисным патч-панелью без документированного исключения.
Маркировка портов на свитче совпадает с кабельным журналом. «Порт 3 - резерв» без кабеля лучше, чем резерв с петлей. Связь с промышленными сетями: физика и практика - там топология и кабель; здесь поведение при неправильном свитче.
Замена офисного на industrial: типовые ошибки при миграции
Скопировали настройки «как было» - не включили IGMP и storm control, потому что на старом не было. Оставили кольцо физически, включили RSTP на новом свитче без согласования с остальным кольцом завода - получили другой вид outage.
Перенесли все VLAN с IT свитча на OT без разделения - сломали изоляцию. Правильный путь: сначала топология и изоляция, потом миграция узлов по одному, мониторинг counters 48 часов.
Потери циклов ПЛК: сеть как скрытый фактор загрузки
Когда интегратор оптимизирует программу ПЛК «цикл 20 мс стал 35 мс», редко смотрят на Ethernet. При flood на NIC контроллера растёт время обработки стека, особенно если в том же процессоре Modbus TCP slave и Profinet stack. Симптом: цикл задачи удлиняется без изменения ST, watchdog не срабатывает, но опрос HMI деградирует.
На объекте с несколькими HMI, каждый опрашивает ПЛК напрямую через офисный свитч, суммарный трафик запросов Modbus может быть выше, чем на FAT с одним ноутбуком. Добавили вторую панель «для мастера» - и лимит буфера свитча стал виден. Решение не только «оптимизировать карту Modbus», но и ограничить polling rate, вынести опрос на SCADA с одним мастером, сменить свитч.
Сравните загрузку CPU и время цикла до и после отключения не критичного порта на свитче в окно остановки. Если цикл падает на 5-10 мс - сеть была частью проблемы, даже если «кабель целый».
Камеры, Wi-Fi и «временно подключили ноутбук»
На цеховом свитче часто живут камеры видеонаблюдения «потому что свободный порт». Камера шлёт multicast или broadcast discovery. ПЛК в том же broadcast domain получает лавину. ИТ говорит «камера работает», АСУ говорит «ПЛК отваливается» - и оба правы в своём слое.
Wi-Fi точка в режиме bridge в шкафу - классический источник петли, когда наладчик забыл отключить после выходных. Ноутбук с двумя активными интерфейсами (Ethernet + Wi-Fi) на том же свитче - мини-мост между VLAN, если Wi-Fi в корпоративную сеть.
Регламент: в шкаф АСУ ТП только OT-устройства по списку. Временные подключения - через отдельный порт с таймером и записью в журнал изменений. На FAT это звучит жёстко, на пуске спасает от «понедельничного» storm.
FAT: что добавить в протокол про свитч
Помимо 30-секундного обрыва, в акт FAT вписать: модель и тип свитча (managed/industrial), схема подключения без незадокументированных петель, отсутствие общего свитча с IT без firewall. Фото портов с маркировкой. Если на стенде офисный - строка «замена на industrial до SAT» с подписью заказчика.
При SAT на объекте повторить проверку топологии: электрики и строители любят «доложить резерв» без уведомления АСУ. Один новый патч между шкафами возвращает storm.
Вопросы с объекта
Можно ли поставить второй офисный свитч «для резерва»?
Два unmanaged без протокола redundancy - почти гарантированная петля или asymmetric path. Резерв - PRP/кольцо на industrial, не дубль патч-корда.
Почему после замены свитча на industrial всё стабильно?
Скорее всего убрали петлю или включили функции, которые раньше отсутствовали. Не «магия бренда», а разница функций.
Нужен ли Wireshark на каждом шторме?
Один 15-минутный захват на mirror при симптоме часто достаточен, чтобы увидеть flood. Регламент - в материале про Wireshark и Modbus TCP.
Кто отвечает - АСУ или ИТ?
Если свитч в шкафу АСУ ТП по проекту OT - интегратор и эксплуатация АСУ. Если «воткнули в корпоративный» - сначала граница OT/IT.
Обсуждение